

Quando acquisti tramite i link sul nostro sito potremmo guadagnare una commissione di affiliazione, senza alcun costo aggiuntivo per l’utente.
Scopri come il Video-to-Video trasforma stile e aspetto dei video esistenti con l’AI, senza dover creare ogni contenuto da zero
Quando si parla di video generati con l’intelligenza artificiale, i primi esempi che vengono in mente sono quasi sempre il Text-to-Video e l’Image-to-Video: si parte da una descrizione per creare una nuova scena oppure da un’immagine statica per aggiungere movimento.
Nella pratica, però, molti creator non partono da zero. Il girato esiste già, il movimento del soggetto funziona, l’inquadratura è corretta e il ritmo è quello desiderato. A dover cambiare è soprattutto l’aspetto visivo: per esempio trasformare una ripresa reale in animazione, provare una nuova direzione artistica o creare più versioni dello stesso contenuto.
È qui che entra in gioco il Video-to-Video: il video esistente continua a fornire la base di movimento e di ripresa, mentre l’IA viene utilizzata per reinterpretarne l’estetica.
Video-to-Video non significa applicare un semplice filtro
Filtri, LUT e color grading modificano soprattutto colore, contrasto, luminosità e atmosfera generale. Il contenuto della scena, invece, rimane sostanzialmente lo stesso.
Il Video-to-Video può intervenire più in profondità. Il modello prende come riferimento il soggetto, i movimenti, la composizione e la dinamica della camera, quindi rigenera il fotogramma secondo una nuova direzione visiva. Una ripresa reale, per esempio, può essere reinterpretata come anime, animazione 3D o clay animation mantenendo come riferimento il movimento originale.
Il punto non è quindi ottenere un effetto più forte di un filtro, ma conservare ciò che nel girato funziona già e cambiare ciò che riguarda la resa visiva.
Quando ha davvero senso usarlo?
Il caso più immediato è la trasformazione di riprese reali in contenuti stilizzati. Un creator può registrare prima la performance, con i movimenti desiderati, e solo dopo sperimentare stili diversi senza dover ricostruire l’intera azione da un prompt.
Lo stesso principio è utile anche per creare varianti di un contenuto social o per testare rapidamente una direzione artistica prima di investire tempo in una lavorazione più complessa.
Se, al contrario, il movimento, l’inquadratura o la recitazione di partenza non funzionano, il Video-to-Video non risolve il problema alla radice: in quel caso può essere più sensato rigenerare la scena o registrarla di nuovo.
Il limite pratico che conta: la durata della clip
L’editing generativo dei video lavora ancora spesso su clip relativamente brevi. Al momento, per esempio, Gemini Omni Flash consente l’editing di video fino a 10 secondi.
Dieci secondi sono sufficienti per provare uno stile o creare un breve effetto. Il flusso di lavoro cambia però quando il materiale dura 30, 45 o 60 secondi: se lo strumento accetta soltanto clip brevi, bisogna dividere il video, generare ogni segmento separatamente e poi ricomporre tutto in montaggio.
Oltre al tempo necessario, la divisione introduce un problema di continuità. Due segmenti generati in momenti diversi possono presentare piccole differenze nel volto, nei dettagli dello sfondo, nei colori o nella resa dello stile. Per questo la durata massima non è soltanto un dato tecnico: può incidere direttamente sulla semplicità del workflow.
Un workflow Video-to-Video più diretto
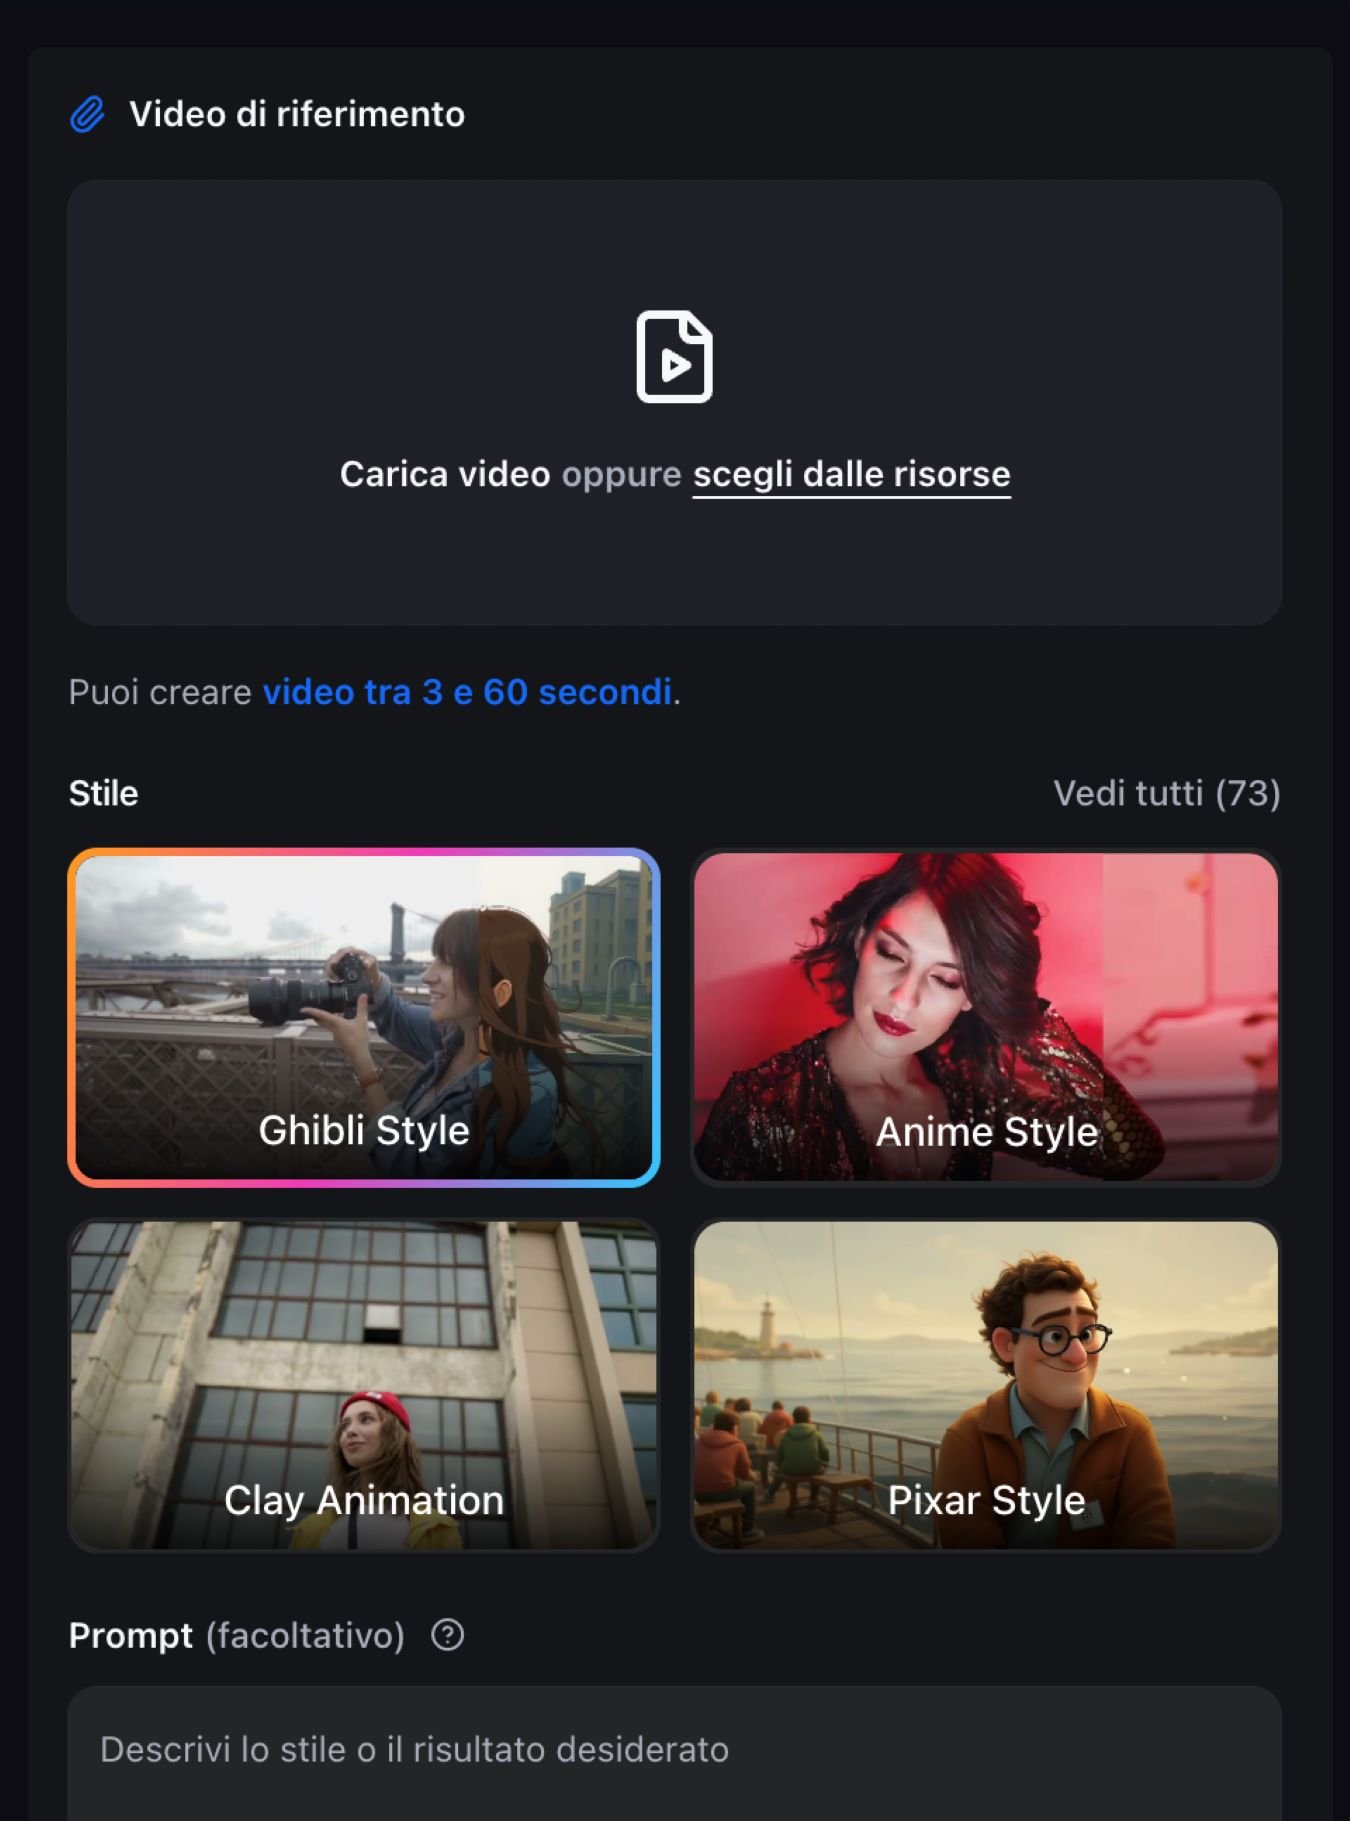
Un esempio è il workflow video to video AI di VidLux, che permette di caricare clip da 3 a 60 secondi, scegliere tra oltre 70 stili e, se necessario, aggiungere un prompt per descrivere con maggiore precisione il risultato desiderato.
Il processo può essere riassunto in quattro passaggi: caricare il video, scegliere lo stile, aggiungere eventualmente un prompt e avviare la generazione.
Per una clip più lunga, poter lavorare fino a 60 secondi significa che molti contenuti brevi possono essere trattati come un unico segmento, senza doverli suddividere solo per rispettare un limite di durata.
Cosa non sostituisce
Il Video-to-Video è utile quando l’obiettivo è cambiare la resa visiva di un girato, ma non sostituisce un editor tradizionale. Movimenti molto rapidi, occlusioni complesse, piccoli dettagli del volto, testi e loghi possono ancora cambiare durante la generazione e richiedono un controllo finale.
Per tagli, sottotitoli, audio, color correction precisa e gestione della timeline, software come Premiere Pro o DaVinci Resolve rimangono strumenti più adatti. Il Video-to-Video occupa semplicemente un’altra posizione nel processo creativo.
La scelta dipende soprattutto dal materiale di partenza: il Text-to-Video è adatto quando non esiste ancora alcuna immagine; l’Image-to-Video quando si parte da una fotografia o da un frame; il Video-to-Video quando movimento e inquadratura sono già corretti ma si vuole cambiare lo stile; l’editing tradizionale quando il contenuto è già definito e serve lavorare su montaggio, audio o rifinitura.
Conservare ciò che funziona già
Il Video-to-Video non deve diventare il punto di partenza di ogni progetto. Il suo valore emerge soprattutto quando una clip ha già movimento, ritmo e inquadratura corretti, ma necessita di una nuova identità visiva.
In questi casi non serve necessariamente ricominciare da zero: si può mantenere la parte già riuscita e utilizzare l’IA generativa soltanto per ciò che si vuole davvero cambiare.


Lascia un commento